llama.cpp releasesTools
b11724
CUDA: fix shared-memory WAR hazard in flash_attn_ext_vec ( #30573 ) CUDA: fix KQ write-after-read race in flash_attn_ext_vec Assisted-by: ChatGPT CUDA: apply review suggestions for KQ sync comments…
Read at llama.cpp releases ↗Related
Toolsb11720 llama.cpp releases
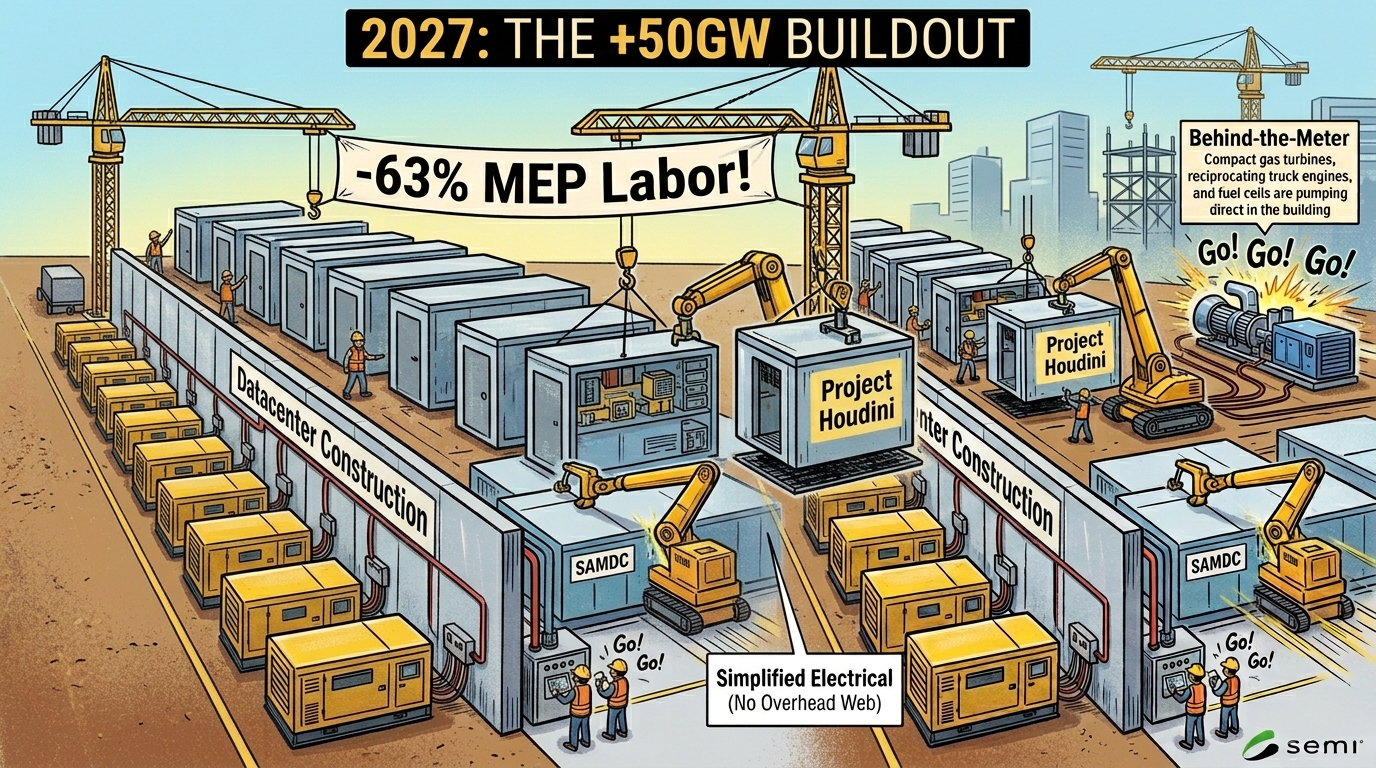
SiliconDatacenters 2027: The Year of Acceleration, +50GW in a Single Year SemiAnalysis
AsiaSG AI cloud provider Aolani eyes Malaysia data center deals Tech in Asia
AsiaShenzhen's International Quantum Academy Entangles Up to Six Phonon Modes on a 2D Chip Pandaily
ValleyNeocloud operator Nscale’s IPO plans could be at risk after Microsoft cancels UK data center project SiliconANGLE