llama.cpp releasesTools
b12149: CUDA: use highest compiled arch in get_mmvq_mmid_max_batch (#31679)
Co-authored-by: DukeNukem-dev [email protected]
Read at llama.cpp releases ↗Related
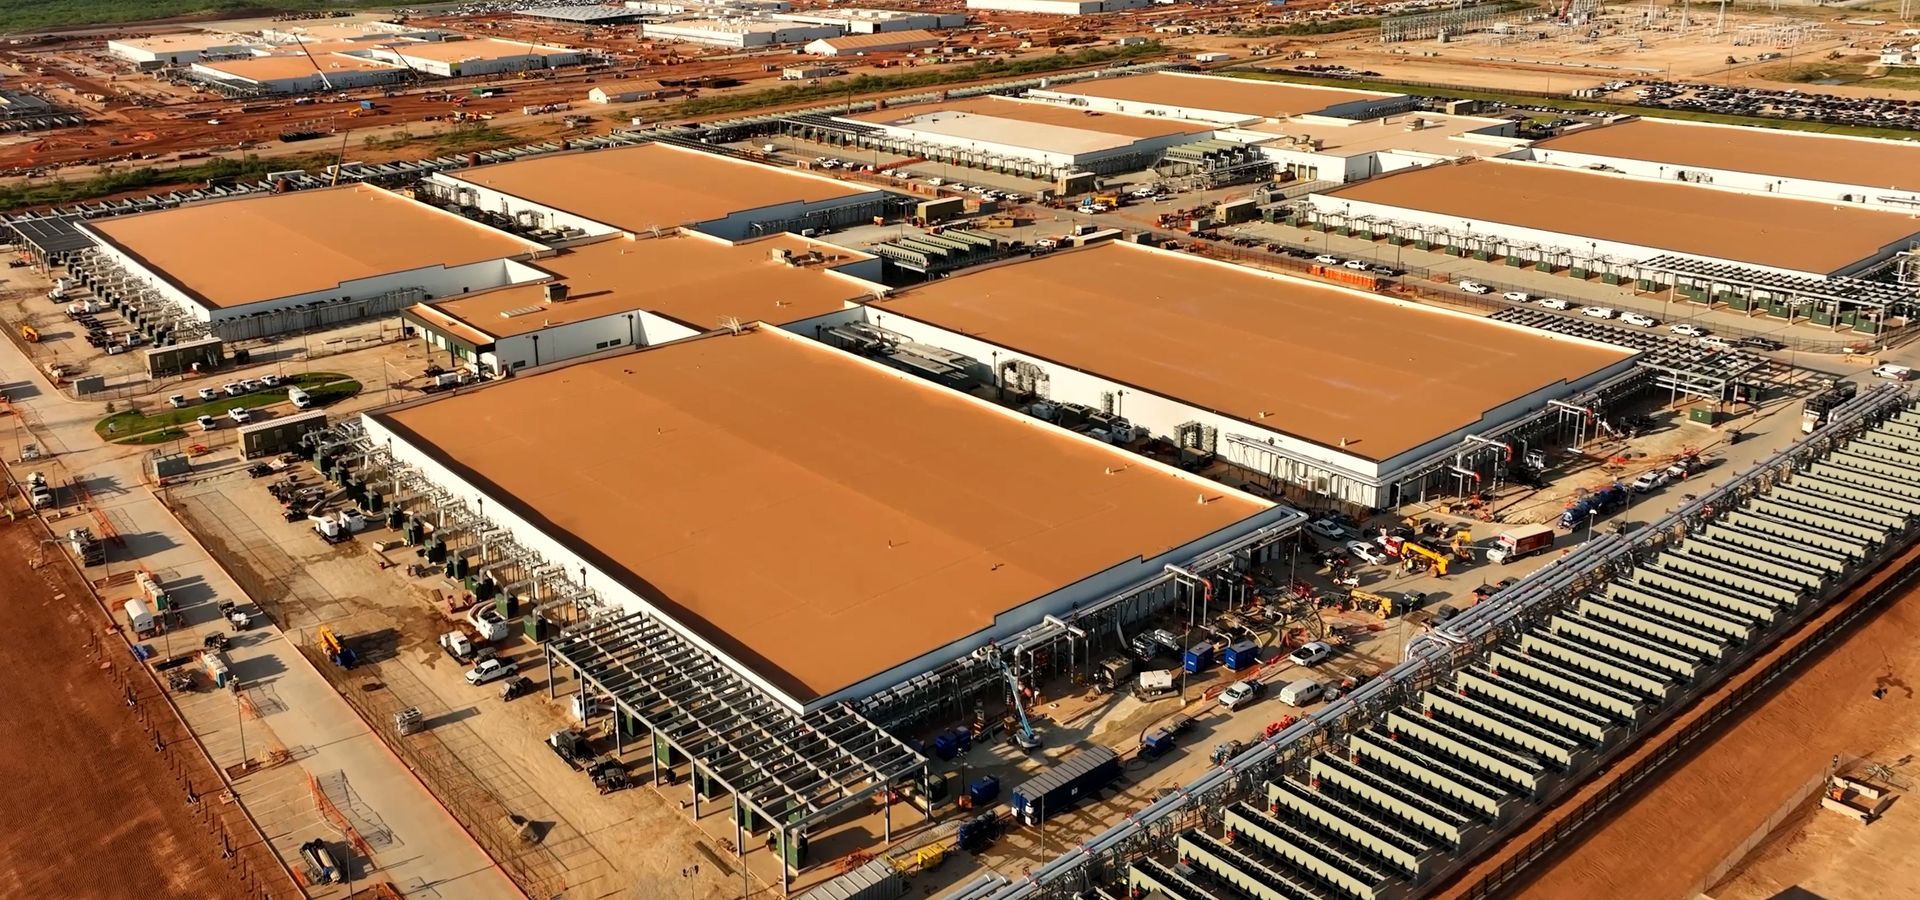
SiliconSpaceX's plan to build more data center compute than Google's entire lifetime capacity in just 1.5 years is possible, say analysts Tom's Hardware
ToolsCLion 2026.3 Is Here JetBrains Blog
ValleyTech giants turn to cash, concessions for AI rebrand after voters pummeled data centers 43-1 Axios Technology
SiliconOmarchy 4.5 Released With Apple Silicon Support, More Desktop Customizations Phoronix

SiliconAdding Network Security To AI, HPC, And Data Centers SemiEngineering
