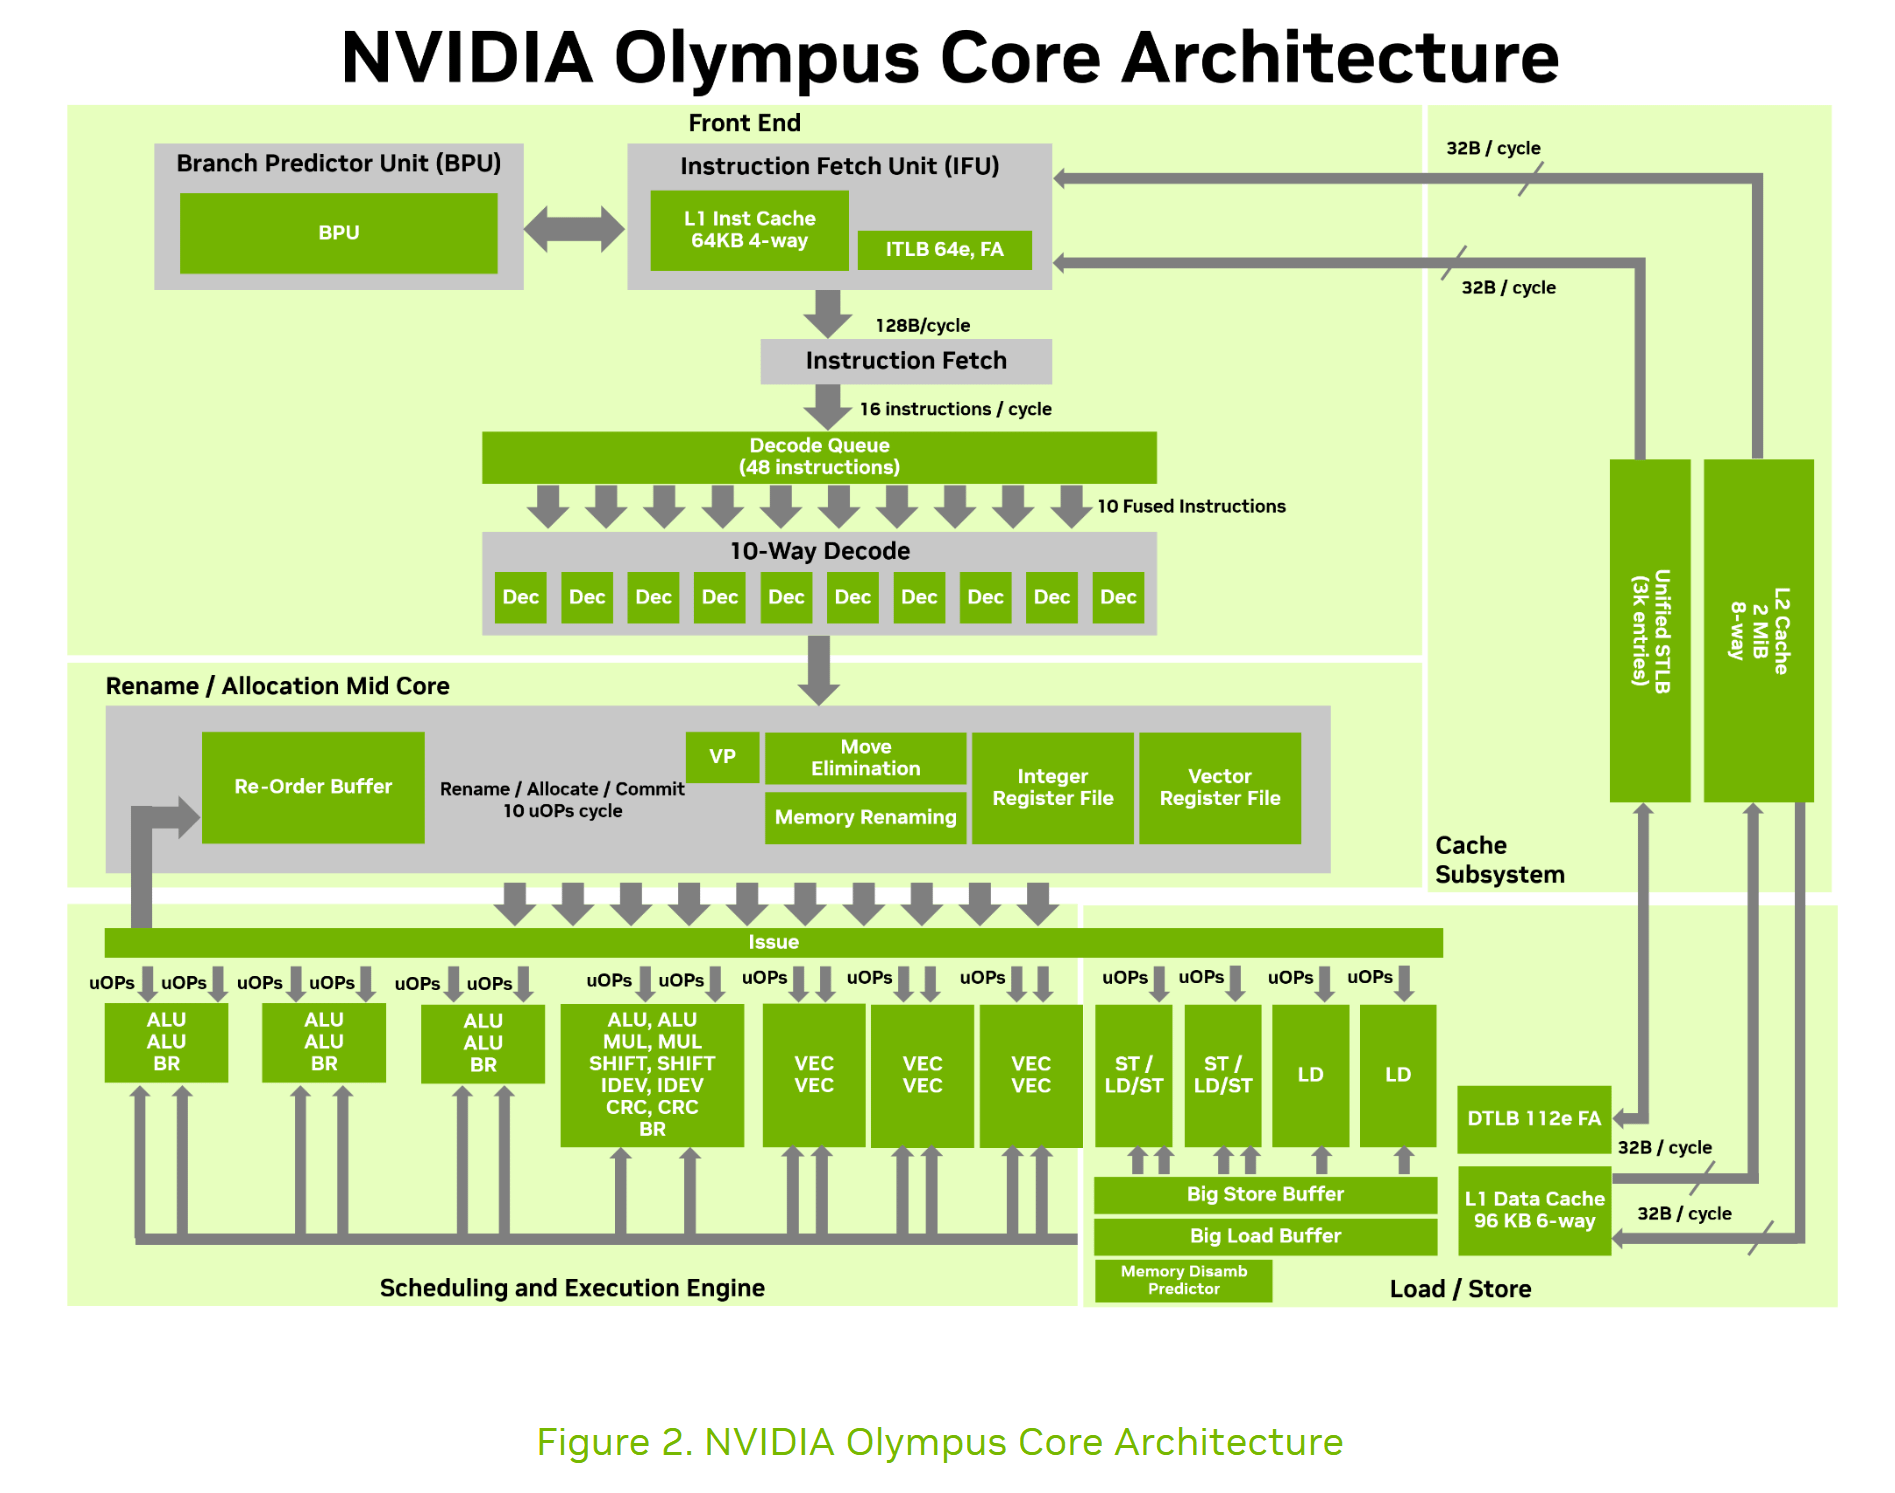
NVIDIA Technical BlogSilicon
Efficient MoE Training for Biological Foundation Models

As language models grow, scaling dense architectures becomes increasingly expensive. In a dense transformer, every token passes through every layer, so adding...
Read at NVIDIA Technical Blog ↗Related

SiliconScaling Federated Learning Across Docker, Kubernetes, and Slurm with NVIDIA FLARE NVIDIA Technical Blog

SiliconAccelerating Dropless MoE Training in JAX with NVIDIA Transformer Engine NVIDIA Technical Blog
AsiaDeepSeek Details DSec Elastic Compute: Agentic-Training Sandboxes at ~3M/Day, 380K+ Concurrent Pandaily
AsiaChina’s Huawei trims mobile chip gap with Apple as Tau Scaling Law pays off: Bernstein SCMP Tech
VoicesMoving Beyond RAG with Precomputed Context Software Engineering Daily