Qiita (LLM)Japan
24GB GPU(RTX 3090/4090/RX 7900 XTX)でローカルLLMは何が動く?数字で確認

4Kコンテキストで、129モデル中97が24GBに快適に収まり、102が一応ロード可能。 同じ24GBでも速度は帯域次第:Tesla P40の346 GB/sからRTX 4090の1,008 GB/sまで。生成速度はおおよそ「帯域 ÷ 重みファイルサイズ」。 Qwen3....
Read at Qiita (LLM) ↗Related

JapanNVIDIA、音声の文字起こし・翻訳を行うAIモデル「Nemotron 3.5 Transcribe」を公開 gihyo.jp
JapanOracle CloudがGoogle TPU導入を発表、2027年に提供を開始。Oracle AI World 2026 Publickey
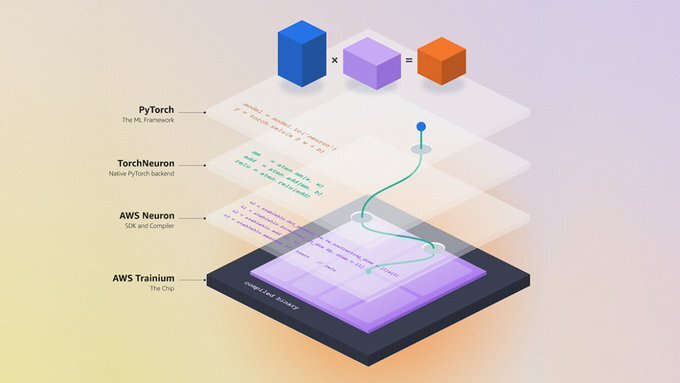
JapanAWSとGoogle Cloudが「PyTorch」のAWS Trainium、Google Cloud TPU対応版をオープンソースで公開。NVIDIAからの移行に挑む Publickey
Toolsb12109 llama.cpp releases

Japan同じRAGでも答えは変わる。grok-4.3とgpt-oss-120bを2つの失敗ケースで比べてみた Qiita (LLM)