ITmedia AI+Japan
「Claude Haiku 5.5」は本当にコスパがいいのか? 3つの日本語タスクで検証してみた
Anthropicの最軽量モデル「Claude Haiku 5.5」を、3つの日本語タスクで「Sonnet 5.5」「GPT-6 Luna」と比較検証。定型文書では上位モデルに迫る一方、自らの立場を把握した上での返答が必要な課題では回答が揺れた。
Read at ITmedia AI+ ↗Related

JapanClaude Codeデスクトップアプリ、並行作業を進めやすくするセッション管理の改善を案内 gihyo.jp
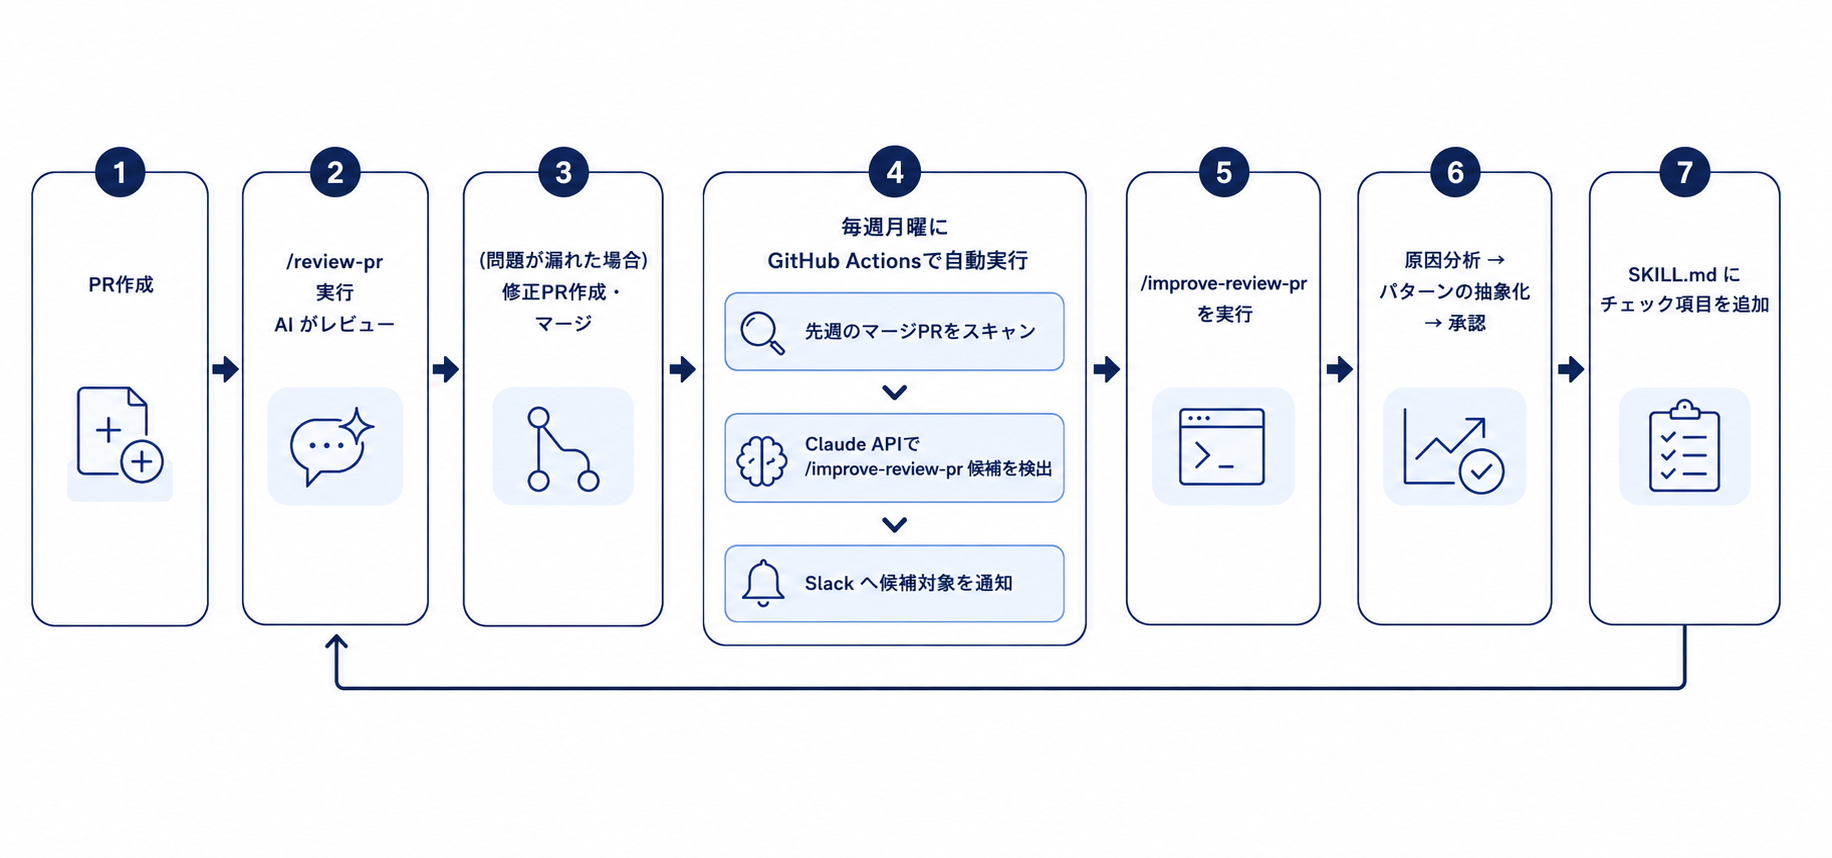
Japan修正PRを食べてレビュースキルが賢くなる:Claude Codeによる自己改善サイクル Mercari Engineering
JapanAnthropic、METRの評価チームを社内に常駐させ“従業員並み”のアクセス付与 公表に拒否権なし ITmedia AI+

LabsWelcome Beam: a 501B open model you can own, customize, and scale Hugging Face Blog
ToolsPerplexity's Decider V1.2 models now available on AI Gateway Vercel Blog