Qiita (LLM)Japan
GLM-5.3のサイバー評価を読む:成功率・試行単位・比較条件を分ける

「成功率12%」「着手率100%」。同じモデルの記事に並ぶ数字でも、測っていることは違います。AIの評価を仕事で使うなら、まず分母と条件をそろえて読みたいところです。 初稿は2026年9月30日。11月3日に一次資料を再確認し、9月の評価を振り返る記事として編集しました。...
Read at Qiita (LLM) ↗More from Qiita (LLM) on Accept All

Japanクラウド型コーディングエージェントとは何か:DeepSeek Super-agent はどこに置けるか Qiita (LLM)
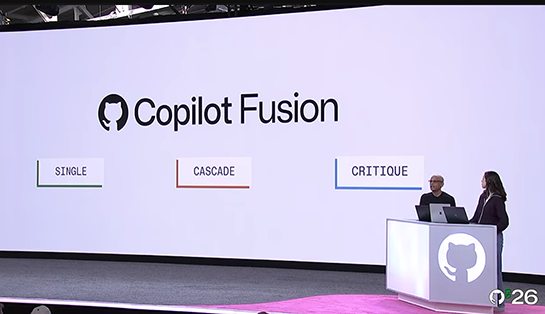
JapanGitHub、「Copilot Fusion」正式リリース。タスクに応じて最適なAIモデル選択で高性能かつ低コストに。GitHub Universe 2026 Publickey

JapanGeminiのカスタムアシスタント「Gem」から「スキル」への移行入門 Zenn (AI)

JapanClaude CodeのPreToolUseフックで、AIに「やらせない」を仕組みにする Zenn (AI)

JapanClaude Code の作業ディレクトリ外の書き込み禁止は Bash・PowerShell に効かない:Windows の実測と止め方 Zenn (AI)
