Qiita (LLM)Japan
ローカル LLM が遅い原因は、モデルでもエンジンでもなく「プロンプトの順序」だった ― プレフィックスキャッシュを効かせるまで

本記事は temi × ローカル LLM シリーズの3本目です。GPU / MLX を検証するまでの過程は前回(part2)の記事に書いています。 前回は、GPU を使うことで生成速度が約1.3〜1.45倍になること、MLX と GGUF の速度差は当環境では数%だ...
Read at Qiita (LLM) ↗Related
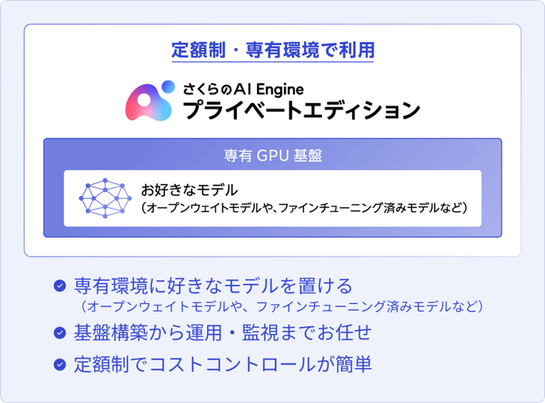
Japanさくらインターネット、GPU専有によりトークン消費量を気にせず定額で利用できる「さくらのAI Engineプライベートエディション」提供開始を発表 Publickey

JapanGoogle、AI電子透かしの検出サイト「SynthID Detector」を一般向けに公開 ——OpenAI・NVIDIA・KakaoのAI生成コンテンツにも対応、Appleの生成物も近く確認可能に gihyo.jp
ValleyOpen specs could cut AI data center hardware integration from a year to months SiliconANGLE

SiliconNVIDIA RTX 5060 Ti 16 GB Price Hikes Put Entry-Level GPU Above $1,200 in Japan TechPowerUp
ValleySupermicro wants AI factories judged by how fast they go live, not by GPU count SiliconANGLE