Qiita (LLM)Japan
M2 MacBook Air 24GB でローカルLLMを実用速度にする② 〜熱スロットリング・KVキャッシュ・計測の落とし穴〜

TL;DR 24GB の M2 MacBook Air でローカル LLM を運用するときに、速度の数字を狂わせる3つの要因を実測しました。 モデル選定の話は ① にまとめています。 ファンレス筐体は GPU フルロード 90 秒で熱スロットリングに入る。 GPU は...
Read at Qiita (LLM) ↗Related
Japan国内GPUサーバでオープンモデルを利用可能に フィックスターズが新サービス まずは「DeepSeek-V4.1-Flash-1017」から ITmedia AI+
JapanOracle CloudがGoogle TPU導入を発表、2027年に提供を開始。Oracle AI World 2026 Publickey
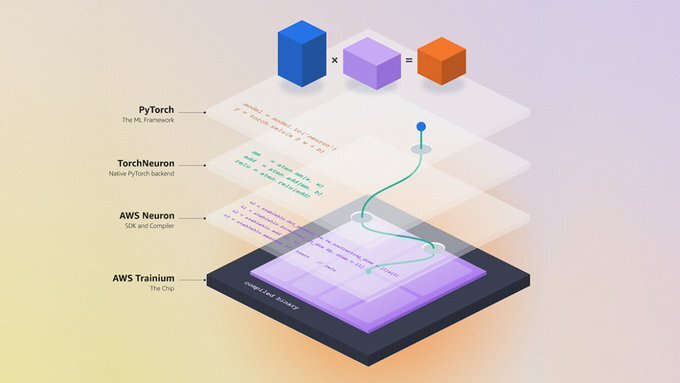
JapanAWSとGoogle Cloudが「PyTorch」のAWS Trainium、Google Cloud TPU対応版をオープンソースで公開。NVIDIAからの移行に挑む Publickey

JapanJEV 1.14とは?分類・是非・評点の三種類で何を判定できるか Qiita (LLM)

AsiaAfter electrification and price wars, SEEWAY.AI says data and chips may define the next decade of EV competition TechNode