Qiita (LLM)Japan
マルチターン攻撃(Crescendo)はなぜ単発の評価で見落とされるのか:会話全体の検査と評価条件を模擬実装で確かめる

LLM のジェイルブレイク評価は、1 回の入力に対してモデルが断るかどうかを見る形が中心です。ところが実際の利用では、ユーザーは何往復も会話を続けられます。無害な質問から始めて少しずつ話を進め、最後にモデル自身の過去の応答を足がかりに目的の出力を引き出すマルチターン攻撃は、...
Read at Qiita (LLM) ↗More from Qiita (LLM) on Accept All

JapanGemini 4 Argonの100万トークンは何がすごい?仕様・料金・制限を公式情報から整理してみた Qiita (LLM)

JapanClaude Code 2.1.299入門、@参照の展開停止とplugin evalのAgent除外を実測 Qiita (LLM)
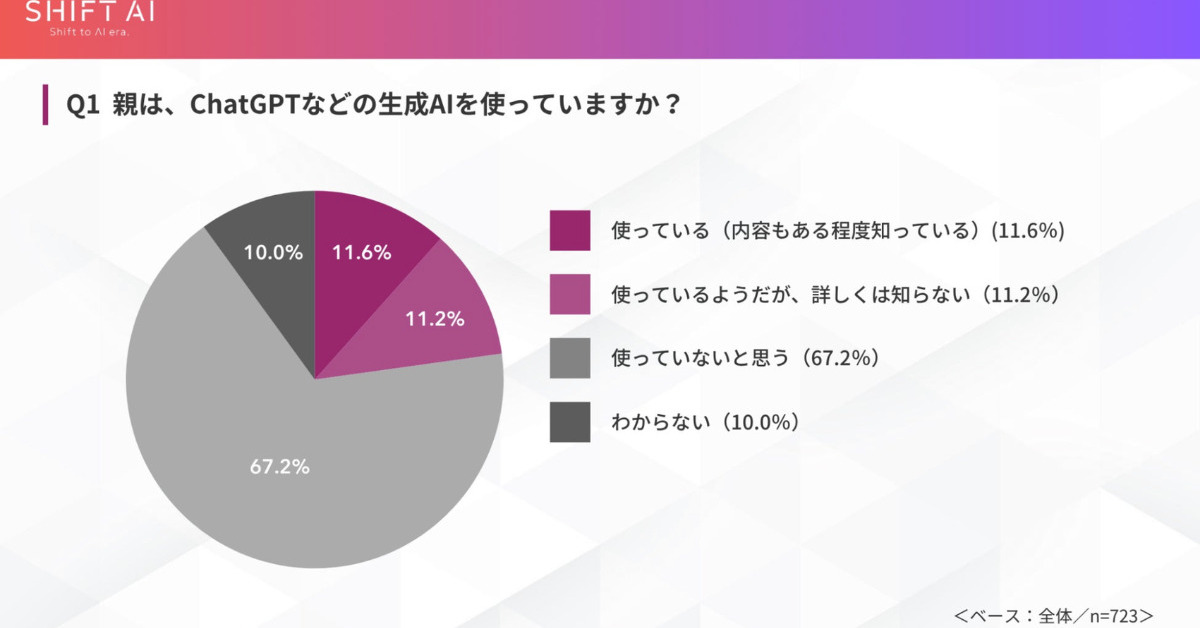
Japan「そもそも親にAIなんて必要ない」 65歳以上の生成AI利用、子世代の7割が拒否する理由 ITmedia AI+
Japan柔術特化HIITアプリを個人開発した記録 ── 構想・仮説検証からVeoとWanによる動画生成パイプラインまで Zenn (AI)
JapanClaude Code の Hook を「誰が検査するのか」問題 ― 観点・テスト・変異テストで品質を育てる Zenn (AI)