Amazon ScienceResearch
When LLM judges agree, should we believe them?

Imagine evaluating a retrieval-augmented-generation system. A user asks a question, the system retrieves a text passage, and an LLM judge decides whether it’s relevant.
Read at Amazon Science ↗Related
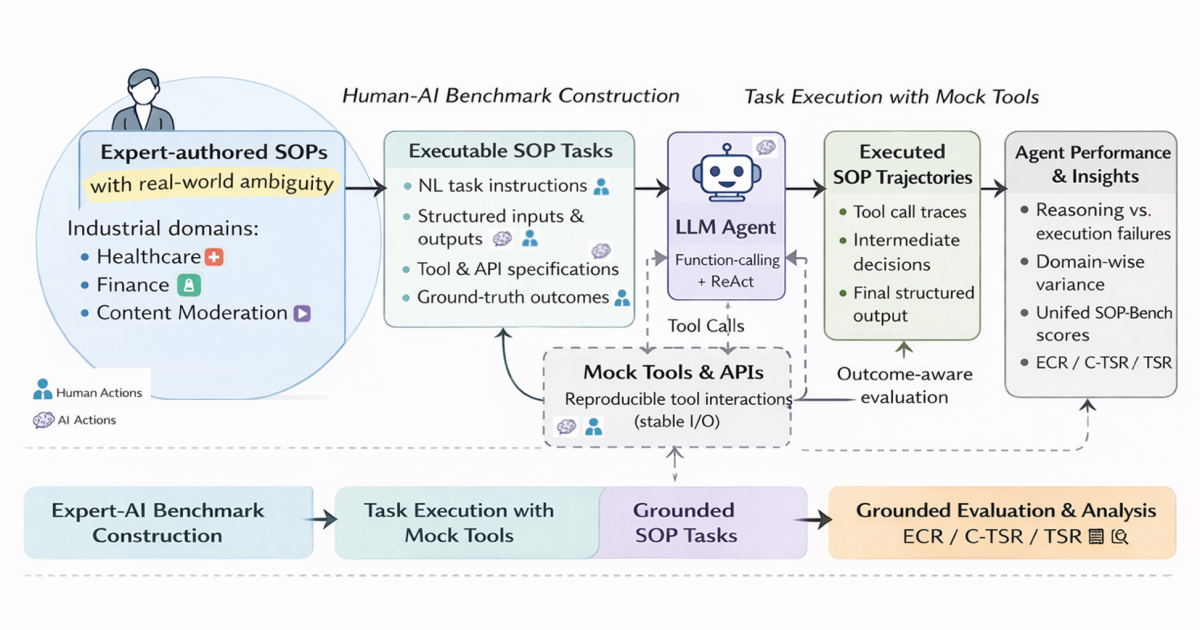
ResearchSOP-Bench: A new benchmark for evaluating AI agents on real business procedures Amazon Science
ResearchA decade of mathematical certainty: Reflections on the Automated Reasoning Group Amazon Science

ResearchA new benchmark for evaluating patient-facing health AI agents Amazon Science

ResearchCapturing token IDs during agentic interactions for better reinforcement learning Amazon Science
ToolsThe 7 best LLM evaluation tools in 2026 Pydantic
